Fashion Labuyai 개인 실험 · 2026년 10 ~ 11월

옷 사진 한 장을
사람 사진에 입히기

옷마다 모델을 다시 학습하지 않고, 옷 사진 한 장을 원래 인물 사진에 입혔습니다. 얼굴과 자세, 배경은 원래 사진 그대로입니다.

같은 24쌍 · 6항목 평균 LoRA → 가상 피팅
2.29에서4.38/6
빈 삼각 자수
0/24 에서 16/24
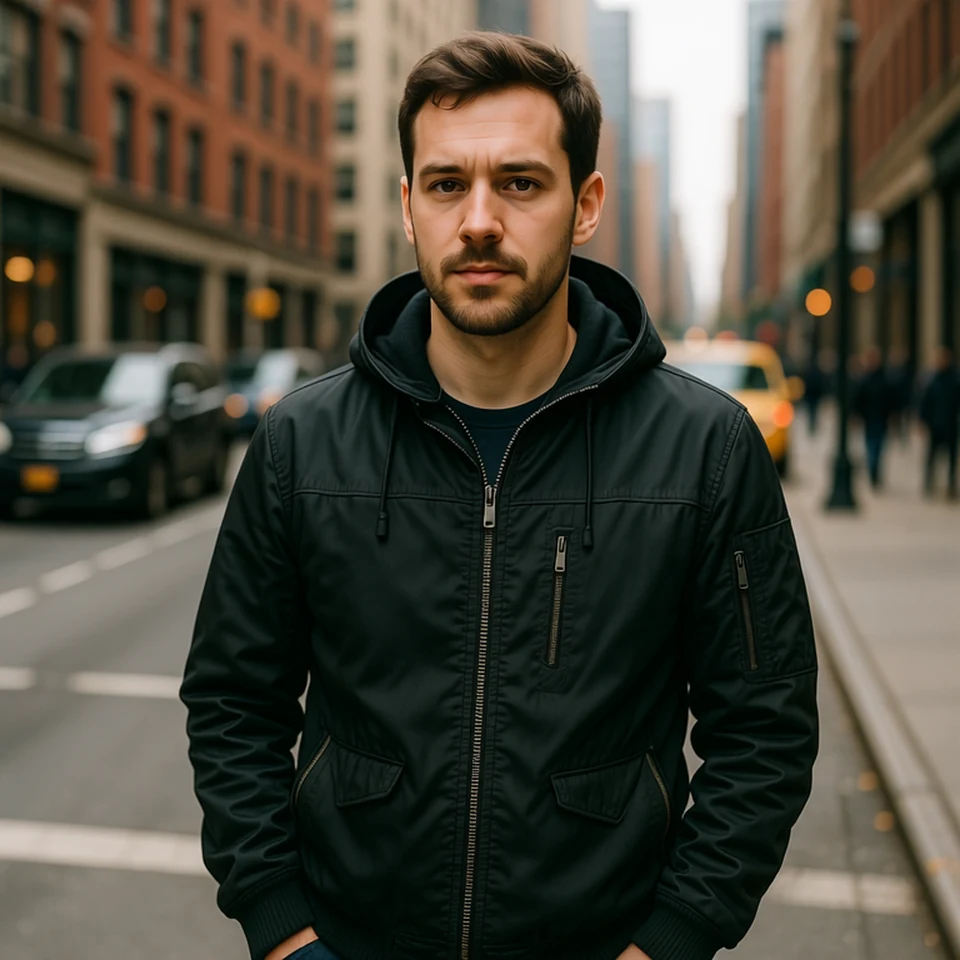
  1. 입력 1, 원래 인물: 검은 후드 재킷을 입고 거리에서 양손을 주머니에 넣은 생성 남성

    입력 1원래 인물

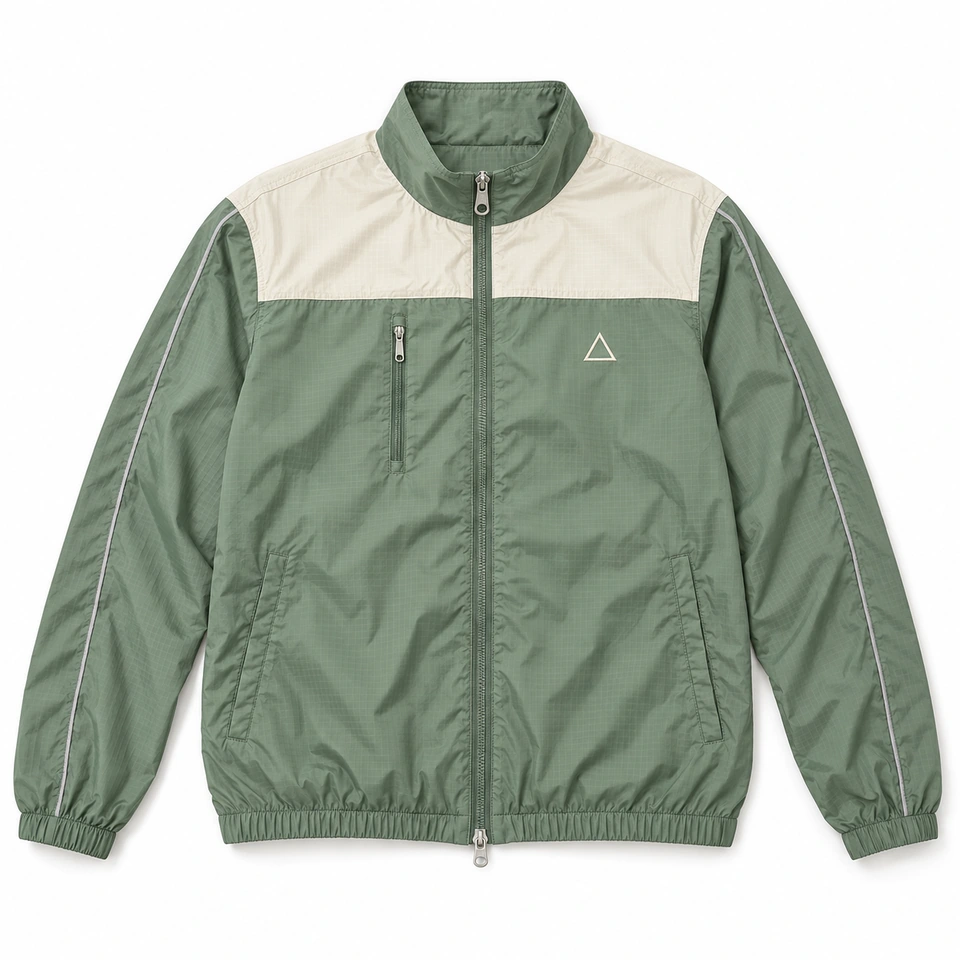
  2. 입력 2, 옷 사진 한 장: 크림 어깨 배색과 빈 삼각 자수, 왼가슴 세로 지퍼가 있는 초록 재킷

    입력 2옷 사진 한 장

  3. 결과 · 가상 피팅같은 얼굴과 자세, 같은 거리에 그 재킷. 한 장 입히는 데 실측 평균 3.6초

1장

색과 소재 편집

  • FLUX.2 [klein] 4BBlack Forest Labs · Apache-2.0
  • ComfyUI사용자 노드 3개로 워크플로 · GPL-3.0

상품컷 한 장을 공개 모델에 참고 이미지로 넣고 색만, 소재만 바꿔 달라고 했습니다. 실루엣과 지퍼는 대체로 남은 채 파란 재킷이 번트 오렌지가 됐고, 겉감은 보풀이 있는 브러시드 질감으로 바뀌었습니다.

그래서 다음엔색과 소재는 바꿀 수 있었지만, 같은 옷을 다른 장면에 그리려면 모델을 이 옷으로 학습시켜야 했습니다.
2장

LoRA 학습

  • SDXL base 1.0Stability AI · CreativeML Open RAIL++-M
  • DreamBooth-LoRAdiffusers · prior preservation

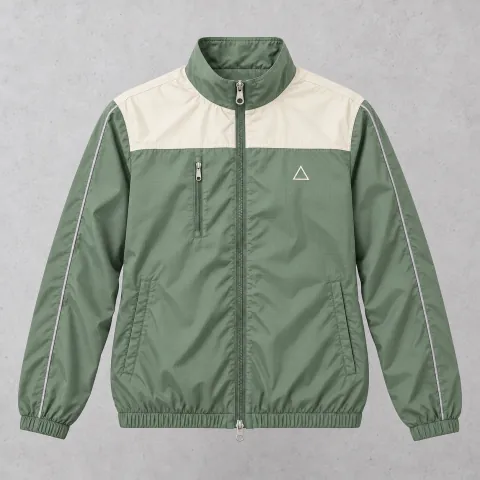
초록 재킷 한 벌을 여러 각도에서 찍은 사진으로 LoRA를 학습했습니다. 학습한 모델이 새로 그린 컷에서도 세이지 그린 몸판과 스탠드 칼라, 중앙 지퍼가 나왔습니다.

그래서 다음엔몸판 색은 나왔지만 넓은 어깨 배색은 거의 나오지 않았습니다. 학습 사진을 늘리고 더 큰 모델로 바꿔도, 문구에 옷 이름만 넣으면 배색이 빠졌습니다.

3장

캡션 다시 쓰기

  • Qwen-Image 20BAlibaba Qwen · Apache-2.0
  • LoRA rank 32캡션 설계: 고유 특징은 빼고 이름만

학습 사진마다 붙인 설명(캡션)을 의심했습니다. 캡션에서 옷의 특징을 지우고 새 이름과 구도만 남겨 다시 학습하자, 같은 모델과 같은 사진으로도 이름만 넣은 문구에서 넓은 어깨 배색이 나왔습니다.

0/48 에서 44/48이름만 넣은 문구 48장 중 넓은 크림 어깨 배색이 나온 장수. 캡션과 이름을 함께 바꿔서 어느 쪽 덕인지는 가리지 못했습니다.

학습 사진에 붙인 한 줄

전a photo of ‹이름› jacket, sage green ripstop, cream shoulder yoke, upright triangle on wearer left chest, zip pocket on wearer right chest, reflective sleeve piping, stand collar, no hood, front flat lay on white.

후a photo of ‹새 이름› jacket, front flat lay on a white background.

그래서 다음엔그래도 작은 빈 삼각 자수는 나오지 않았습니다.

4장

항목별 평가

  • DINOv2 · DINOv3Meta · Apache-2.0 / Meta DINOv3 라이선스
  • CLIPOpenAI · MIT
  • SigLIP 2Google · Apache-2.0
  • GPT 체크리스트VLM-as-judge · 6항목

이미지끼리 얼마나 닮았는지 재는 점수가 높아도 그 옷이 아닐 때가 있었습니다. 2장의 새 컷도 1차 결과 가운데 닮음 점수가 가장 높았지만 어깨 배색이 없었습니다. 그래서 그 옷인지를 항목 여섯 개로 나눠, 한 장씩 맞았는지 셌습니다.

평가 기준 사진: 학습에 쓰지 않은 초록 재킷 정면

기준 사진에서 세는 여섯 가지

  1. 넓은 크림 어깨 배색
  2. 빈 삼각 자수 1개
  3. 자수는 오른가슴(화면 기준)
  4. 왼가슴 세로 주머니
  5. 후드 없음
  6. 옷에 글자나 로고 없음

그래서 다음엔학습으로 새로 그리는 대신, 옷 사진을 그대로 입혀 보기로 했습니다.

5장

가상 피팅

  • FASHN VTON v1.5FASHN AI · Apache-2.0 · 상업 이용 가능(마스크 없이)
  • LeffaMIT · 비교에만 · 전처리 OpenPose 비상업

옷 사진 한 장을 인물 사진에 입히는 가상 피팅 전용 모델 FASHN VTON으로 바꿨습니다. 같은 장면과 사람 24쌍에서 3장의 LoRA보다 6항목을 더 많이 맞혔고, 얼굴과 자세, 배경은 원래 사진 그대로였습니다. 점수만 보면 Leffa가 조금 더 높았지만, 전처리에 쓰는 OpenPose가 비상업 라이선스라 Leffa는 비교에만 썼습니다.

0/24 에서 16/2424쌍 중 빈 삼각 자수가 나온 장수(LoRA에서 가상 피팅으로)

그리고 지금원래 옷의 후드가 남거나 가슴 주머니가 빠진 컷도 있어서, 평균은 6항목 중 4.38입니다.

크레딧이 실험에 쓴 오픈소스

가중치나 코드가 공개된 모델과 도구입니다. 상업 이용 칸은 이번에 쓴 방식을 기준으로 적었습니다.

참고이미지와 점수

이미지는 모두 생성 이미지이고, 실제 옷의 핏을 검증한 결과는 아닙니다. 6항목 평균과 장수는 GPT 체크리스트로 판정한 값입니다.

이미지